Ledningen tror en sak om AI. Medarbetarna gör en annan. Vi mäter skillnaden.
De flesta AI-mätningar frågar ledningen och får tillbaka ledningens självbild. Vi intervjuar båda sidor, avdelning för avdelning, och visar var bilden och verkligheten går isär – och varför.
Hur stor del av era AI-möjliga uppgifter görs faktiskt med AI varje vecka?
Svara två gånger. Först som ledningen skulle svara. Sedan som du tror att medarbetarna skulle beskriva sin vecka.
Den andra siffran var svårare att sätta. Det är hela poängen. Den finns inte i någon rapport, för ingen har frågat på rätt sätt.
Varför de flesta AI-mätningar missar.
Ett team skrev 300 brev om dagen för hand. Någon föreslog ett makro. En kollega satte stopp – ”då blir vi arbetslösa” – och breven skrevs för hand i flera år till. Samma kollega utsågs till årets medarbetare.
Motståndet var inte irrationellt. Det var en korrekt läsning av vad organisationen belönade: volym. Systemet fungerade precis som det var byggt.
Den vanligaste åtgärden mot ett systemfel är att byta ut människor.
När ledningen ser låg AI-användning och drar slutsatsen ”vi har inte rätt personer” har de ofta gjort just det. Vi mäter det som sitter i systemet – så att ni inte behöver gissa på människorna.
Ingen betygsätter sig själv. Man beskriver – vi kodar.
Strukturerade intervjuer med ledning och medarbetare. Samma frågor varje gång, kodade mot samma rubriker, så att resultaten går att jämföra mellan avdelningar, organisationer och över tid.
- 01Beskriv din vanliga veckaIntervjun börjar helt utan AI. Då vet vi om en uppgift saknas för att den inte görs – eller för att ingen kom på den.
- 02Uppgift för uppgiftEtt register byggt på O*NET, den öppna amerikanska yrkesdatabasen. Hur ofta frågas alltid, gissas aldrig.
- 03Båda sidorLedningen beskriver vad de tror sker. Medarbetarna beskriver vad de gör. Skillnaden är resultatet.
- 04Kodat mot rubrikSvaren poängsätts mot fasta rubriker och kalibreras mellan kodare. Instrumentet anpassas aldrig efter kund – det är det som gör det jämförbart.
Sex dimensioner – och den viktigaste är den sista
En rapport per avdelning. Fyra fynd som brukar svida.
Vi säljer inte lösningen. Därför kan ni lita på diagnosen.
Om samma bolag som mäter också säljer AI-system eller implementering blir varje fynd ett säljargument. Det är samma skäl som skiljer revision från konsulting.
- Vi säljer inga AI-verktyg och inga licenser.
- Vi implementerar inte det vi hittar.
- Vill ni ha hjälp vidare hänvisar vi till partners – utan provision till oss.
Medarbetarna måste kunna svara ärligt. Så vi gör det omöjligt att peka ut någon.
Vi har inte hittat på ramverket. Vi har hittat där det tar slut.
Lagren i mätningen växte fram ur praktiken – och visade sig redan vara beskrivna i beteendeforskningen. Vi bygger på den och säger det öppet.
Det som saknas är data på uppgiftsnivå. Publicerad forskning mäter om en funktion använder AI, inte vilka av dess uppgifter. Det kräver primärdata som ingen har samlat in. Det är det vi gör.
- COM-B – kan de, får de, lönar det sig?Michie, van Stralen & West 2011
- TDF – grunden för intervjufrågornaCane, O’Connor & Michie 2012
- AACTT – beställningens precisionPresseau m.fl. 2019
- Belöna A, hoppas på B – mätskuldKerr 1975
- Lagom tillit till AI – omdömeSchemmer m.fl.
- O*NET – uppgiftsregistretU.S. Department of Labor
Vi har inte gjort det här för någon ännu. Därför söker vi tre.
Tre organisationer får hela mätningen och en genomgång med ledningsgruppen – utan avgift, mot ett skrivet utbyte. Vi söker tre som skiljer sig från varandra, för det är skillnaderna som visar att mätningen fungerar.
- Mätningen av [2–4] avdelningar, ledning och medarbetare
- Rapporten, avdelning för avdelning
- En genomgång med ledningsgruppen
- Rätt att använda resultaten anonymt i vår jämförelsedatabas
- Ett namngivet referenscase och ett citat
- Ett förhandsavtalat pris för en ommätning om sex månader
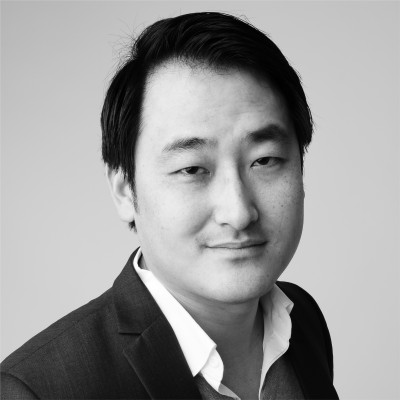
Tobias Carneteg, grundare
Drygt 20 år som ledare för kundservice och contact center – egna och outsourcade, med team på upp till 24 personer. Jag har infört AI och automation i kundflöden, tagit fram business case för AI i första linjen och sett på nära håll hur långt det kan vara mellan det ledningen beslutar och det som faktiskt händer på golvet.
25 år som ledare och tränare i idrotten har lärt honom samma sak som arbetslivet: man får det beteende man belönar – inte det man ber om.
Vill ni vara en av de tre?
Berätta kort om er organisation. Vi hör av oss inom två arbetsdagar.